Block
Database e virtualizzazione
Volumi condivisi, multipathing, latenza prevedibile e protezione coerente per hypervisor, database e cluster applicativi.
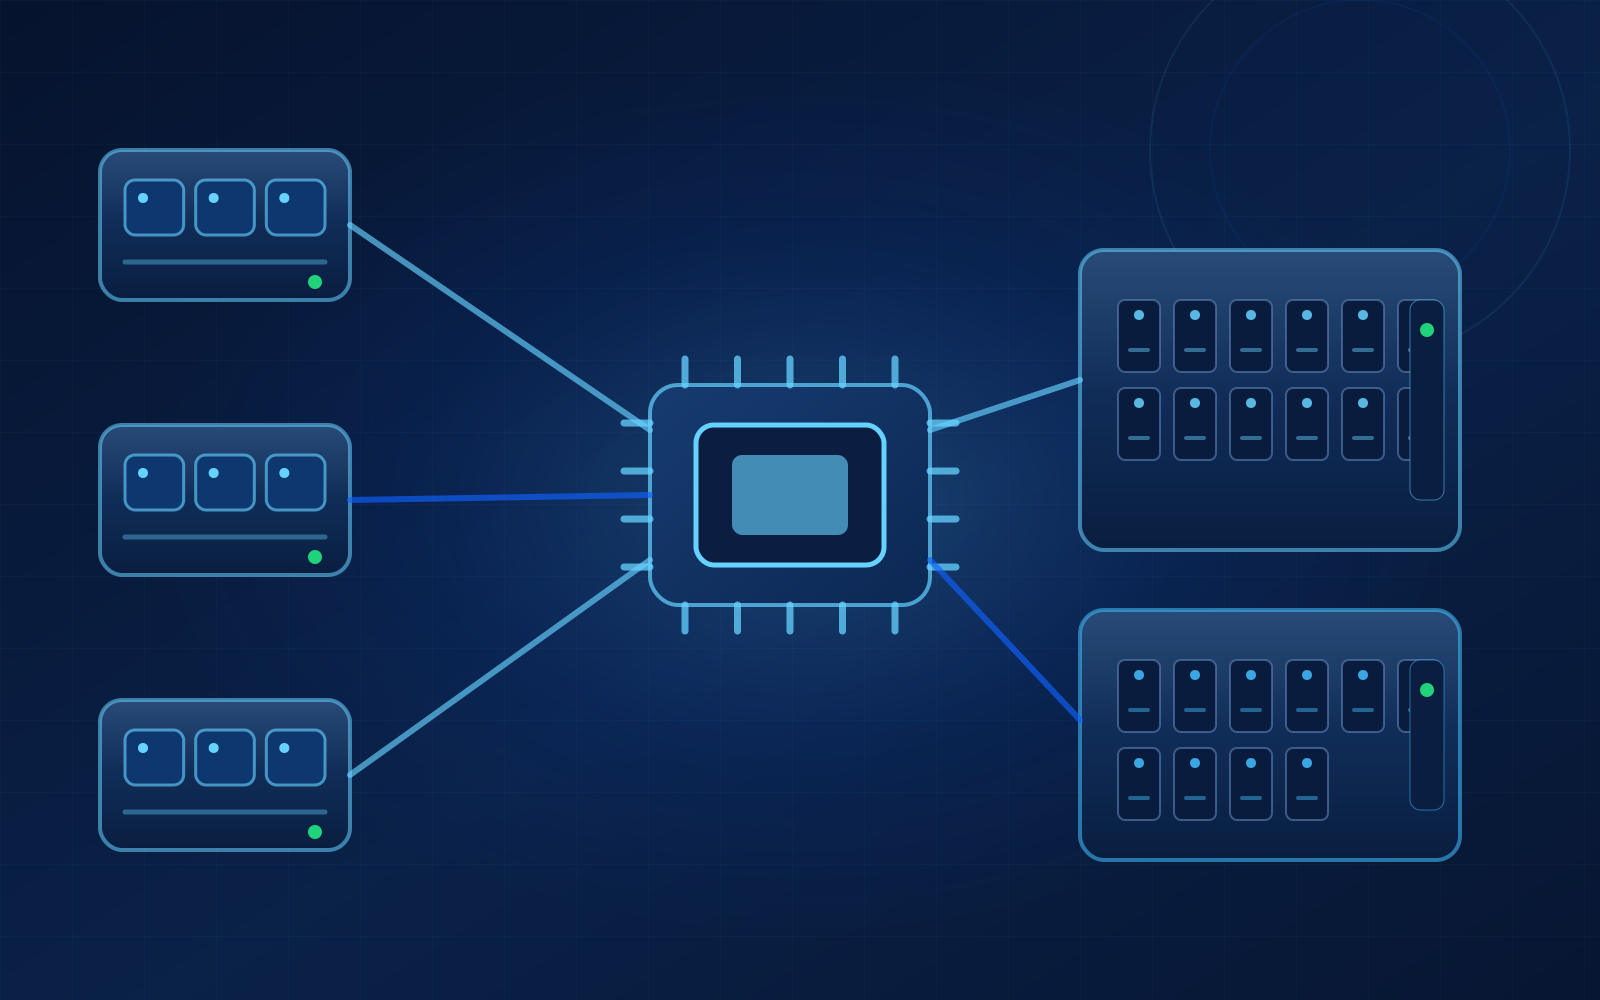
Progettiamo storage block, file, object e paralleli, dimensionando capacità utile, prestazioni, ridondanza e recupero sul comportamento delle applicazioni.

Raccogliamo capacità attuale e crescita, rapporto letture e scritture, dimensione dei blocchi, IOPS, throughput, latenza, numero di client e quantità di file. Questi parametri distinguono, per esempio, un database da un repository documentale o da uno scratch HPC.
Definiamo inoltre capacità utile dopo RAID, replica o erasure coding, fault domain, RPO, RTO, retention e modalità di manutenzione. In questo modo ridondanza, backup e replica non vengono trattati come funzioni equivalenti.
Block, file e direct attached
Le SAN presentano volumi block a hypervisor, database e cluster tramite Fibre Channel o iSCSI, con multipathing e controller ridondati quando richiesto. I NAS forniscono namespace e condivisione tramite SMB e NFS, con gestione di permessi, quote e snapshot.
Il DAS collega direttamente capacità al server tramite NVMe o SAS ed è adatto quando bassa latenza, semplicità o isolamento prevalgono sulla condivisione. La scelta di RAID, HBA, cache e dischi dipende dal carico e dai tempi di rebuild accettabili.

Software-defined e scale-out
Ceph può fornire servizi block, file e object su un cluster distribuito. Richiede un progetto coerente di nodi, rete, replica o erasure coding e domini di guasto, oltre a procedure operative per aggiornamenti e monitoraggio.
Open-E JovianDSS utilizza ZFS per realizzare storage software-defined con snapshot, replica e configurazioni ad alta disponibilità. Può essere valutato per SAN, NAS, protezione off-site e appliance costruite su hardware validato.
Parallelo e protezione
BeeGFS e Lustre distribuiscono dati e metadata su più server per aumentare accesso concorrente e throughput. Il progetto considera client, target, metadata, rete RDMA, file piccoli e rapporto tra NVMe e capacità HDD.
La protezione viene progettata con snapshot, replica, backup, copie immutabili e off-site, in funzione di RPO e RTO. La disponibilità si verifica con procedure di rebuild, failover e test di ripristino, non con la sola presenza di componenti ridondati.

In un’unica infrastruttura possono convivere livelli differenti, purché protocolli, prestazioni e protezione siano definiti per ciascun workload.
Block
Volumi condivisi, multipathing, latenza prevedibile e protezione coerente per hypervisor, database e cluster applicativi.
File
SMB e NFS con permessi, quote, snapshot e gestione efficiente di namespace e file di piccole dimensioni.
Parallel
Throughput aggregato, metadata, scratch e checkpoint per molti client che leggono e scrivono contemporaneamente.
Protection
Throughput sequenziale, immutabilità, retention, copie off-site e procedure di ripristino verificate.
Il progetto può combinare appliance, sistemi software-defined e livelli di capacità, mantenendo gestione e protezione coerenti.
Volumi condivisi per database, hypervisor e applicazioni critiche.
Condivisione centralizzata di file, namespace e permessi.
Servizi distribuiti o basati su ZFS per dati strutturati e non strutturati.
Accesso distribuito ad alta banda per cluster HPC e AI.
Protezione e recupero definiti sui livelli di servizio.
Sono utili capacità attuale e crescita, applicazioni, IOPS o throughput, protocolli, numero di client, RPO, RTO, retention e infrastruttura di rete.