Engineering
Simulazione e progettazione
CAE, CFD, FEM e simulazioni multi-physics possono richiedere CPU ad alta banda di memoria, comunicazioni MPI e storage per checkpoint.
Progettiamo infrastrutture CPU e GPU complete di interconnessione, storage parallelo, provisioning, scheduler e monitoraggio. Il dimensionamento parte dai workload, dai dataset e dai tempi di esecuzione richiesti.

Analizziamo software, grado di parallelismo, uso di CPU o GPU, memoria per job, durata delle elaborazioni e numero di utenti concorrenti. Questi dati permettono di definire il nodo tipo e il numero di nodi senza basarsi soltanto sulla potenza teorica.
Valutiamo anche dimensione dei dataset, letture e scritture concorrenti, spazio scratch, crescita, licenze, code di lavoro e integrazione con l’infrastruttura esistente. Il risultato è un’architettura con ipotesi, margini e criteri di espansione espliciti.
Nodi di calcolo
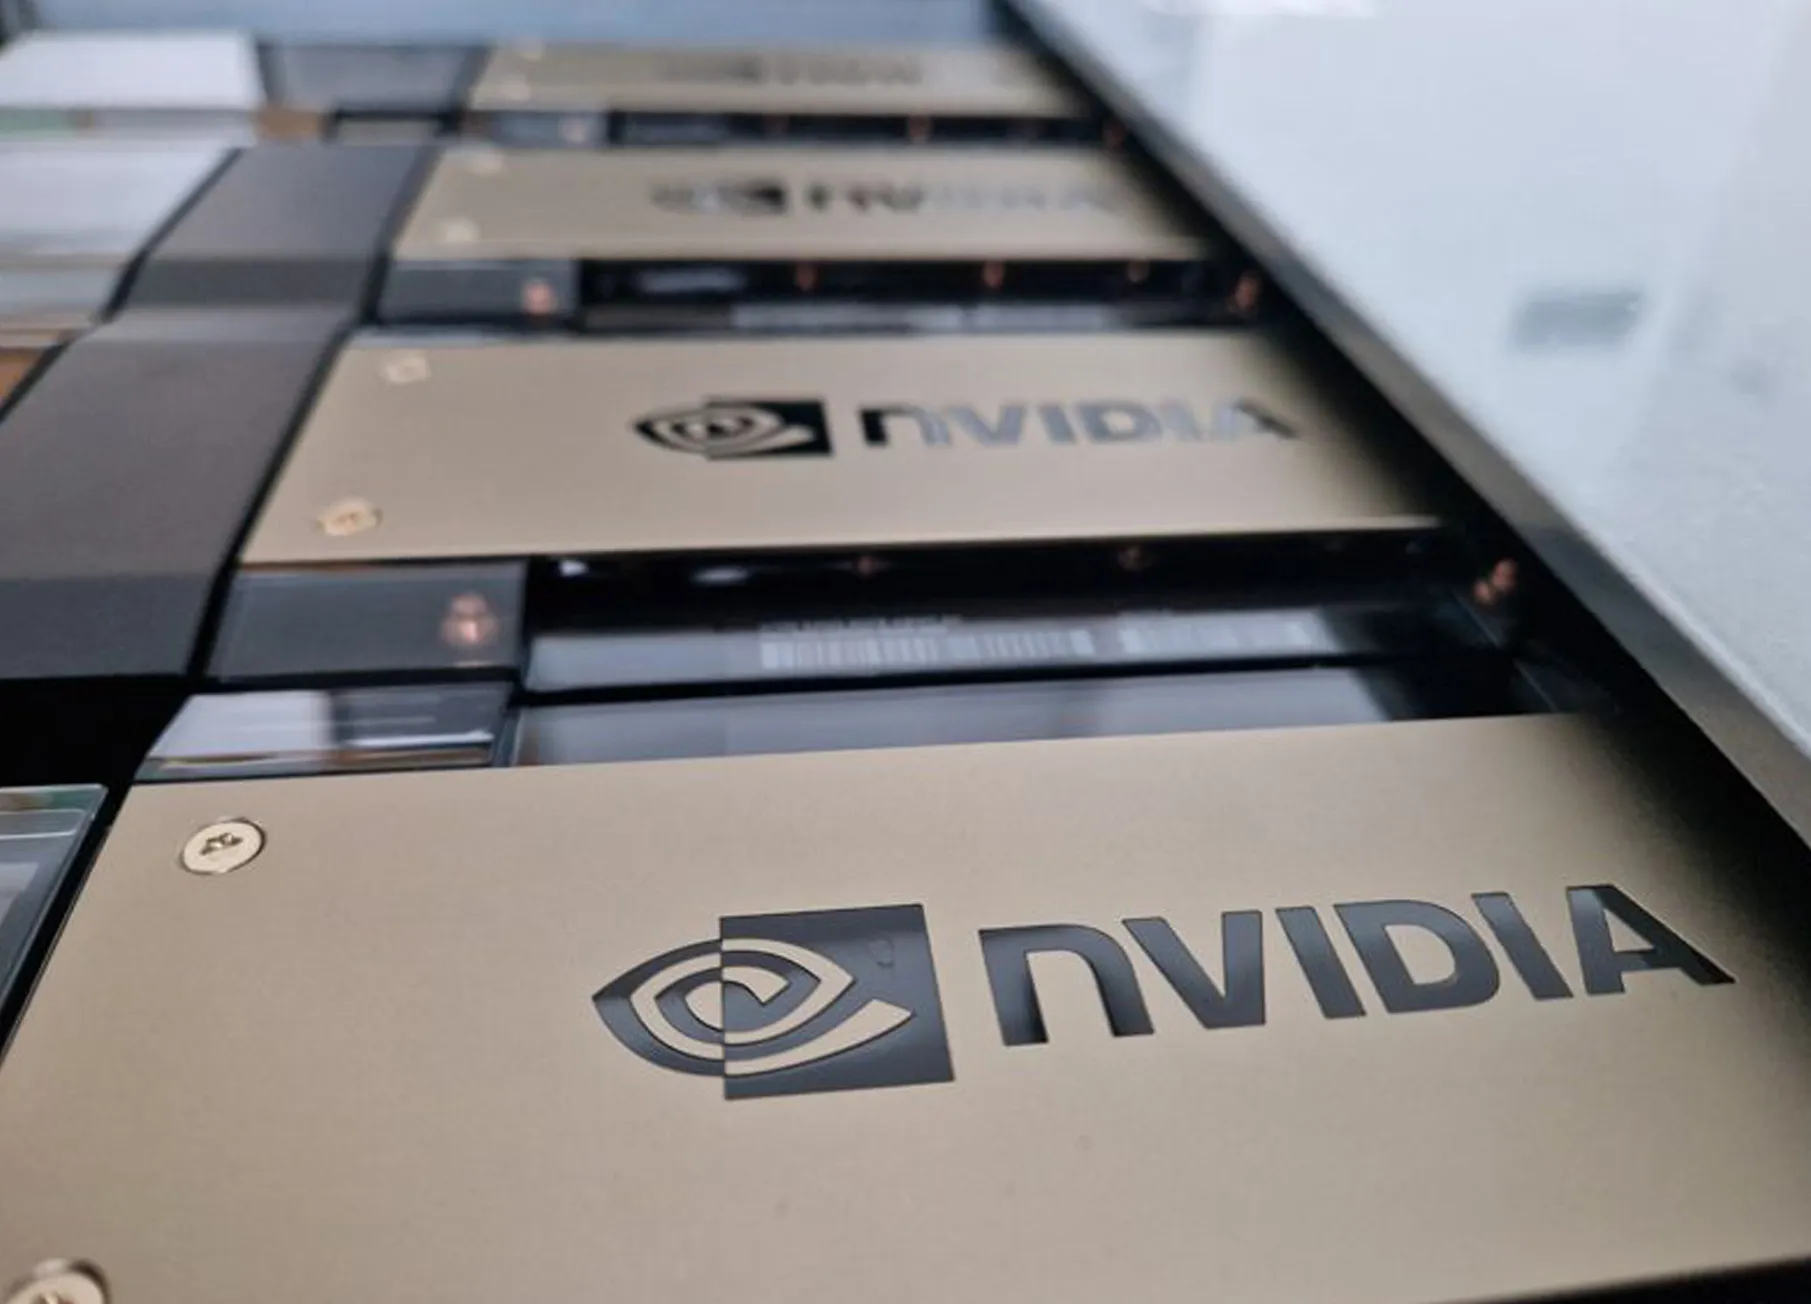
Per workload MPI, simulazioni e calcolo numerico verifichiamo numero di core, frequenza, banda di memoria e memoria disponibile per processo. Per AI, rendering o calcolo accelerato valutiamo tipo e numero di GPU, memoria GPU, collegamenti PCIe e rapporto con le CPU.
Il nodo può includere NVMe locale per sistema operativo, cache o scratch temporaneo. Nei cluster misti definiamo partizioni CPU, GPU o ad alta memoria, così lo scheduler può assegnare le risorse corrette a ogni job.

Fabric e accesso ai dati
La rete di calcolo può utilizzare InfiniBand o Ethernet con RDMA, in funzione della sensibilità a latenza, banda e comunicazioni tra nodi. Topologia, ridondanza e rapporto di concentrazione vengono definiti sul numero di nodi e sul traffico atteso.
Per l’accesso condiviso valutiamo BeeGFS, Lustre o altri file system paralleli, separando quando necessario metadata, capacità e livelli NVMe o HDD. Il dimensionamento considera throughput aggregato, IOPS, file piccoli, checkpoint e accesso concorrente.
Gestione e data center
La soluzione può includere provisioning dei nodi, scheduler come Slurm, repository software, monitoraggio, telemetria e gestione BMC. Le reti di management, calcolo e storage vengono separate e documentate.
Prima della configurazione verifichiamo assorbimento per nodo e per rack, PDU, cablaggio, airflow e temperatura ambiente. Per densità elevate può essere valutato il raffreddamento diretto a liquido, insieme a ridondanza e manutenzione.
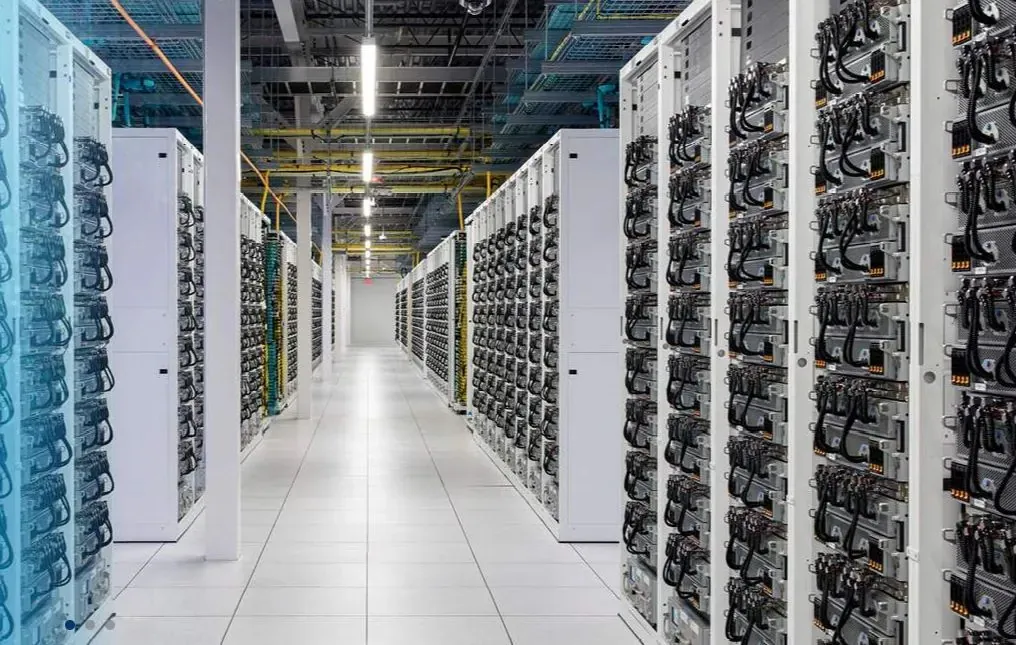
La stessa piattaforma può combinare più code o partizioni, ma ogni applicazione impone un diverso rapporto tra calcolo, memoria, rete e storage.
Engineering
CAE, CFD, FEM e simulazioni multi-physics possono richiedere CPU ad alta banda di memoria, comunicazioni MPI e storage per checkpoint.
Research
Genomica, fisica, chimica computazionale e climatologia combinano job batch, ambienti software differenti e dataset condivisi.
AI
Training e inferenza richiedono GPU adeguate al modello, memoria acceleratore, rete tra nodi e un percorso dati che alimenti le GPU.
Data intensive
Bioinformatica e analytics richiedono preprocessing, molti file, metadata rapidi e spazio scratch separato dai dati persistenti.
Ogni voce viene associata a requisiti misurabili, compatibilità software e possibilità di espansione.
Configurazioni single o dual socket, nodi accelerati e nodi ad alta memoria.
Rete per MPI, RDMA, accesso storage e management.
File system condiviso per dati persistenti, scratch e checkpoint.
Provisioning, scheduler, monitoraggio e controllo del ciclo di vita.
Verifica elettrica, termica e meccanica dell’infrastruttura.
Sono utili applicazioni utilizzate, numero di utenti e job, dataset, tempi attesi, crescita, software richiesto e vincoli del data center.